Ver el código
_, K4 = cadena_masas_muelles(4)
(colptr = K4.colptr, rowval = K4.rowval, nzval = K4.nzval)
(colptr = [1, 3, 6, 9, 11], rowval = [1, 2, 1, 2, 3, 2, 3, 4, 3, 4], nzval = [2.0, -1.0, -1.0, 2.0, -1.0, -1.0, 2.0, -1.0, -1.0, 1.0])A1 · Matrices estructuradas
En una estructura discretizada, cada grado de libertad solo interactúa con los vecinos: la mayoría de las entradas de \(\mathbf K\) y \(\mathbf M\) son cero. Una matriz dispersa (sparse) es la que tiene muy pocas entradas no nulas; es de banda si todas están a distancia \(\le b\) de la diagonal (\(b\) es el semiancho de banda); es tridiagonal si \(b=1\); y es por bloques si se puede particionar en submatrices.
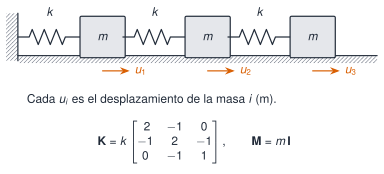
Para \(n\) masas \(m\) unidas por muelles \(k\), con la primera anclada y la última libre, \(\mathbf M=m\mathbf I\) y
\[ \mathbf K=k\begin{bmatrix}2&-1&&\\-1&2&-1&\\&\ddots&\ddots&\ddots\\&&-1&1\end{bmatrix}. \tag{1}\]
Tiene \(3n-2\) entradas no nulas de \(n^2\). Julia almacena las matrices dispersas por columnas comprimidas (CSC, compressed sparse column): en lugar de \(n^2\) números guarda tres vectores, colptr, rowval y nzval. Python, con SciPy, admite CSC y también CSR (la misma idea, por filas).
_, K4 = cadena_masas_muelles(4)
(colptr = K4.colptr, rowval = K4.rowval, nzval = K4.nzval)(colptr = [1, 3, 6, 9, 11], rowval = [1, 2, 1, 2, 3, 2, 3, 4, 3, 4], nzval = [2.0, -1.0, -1.0, 2.0, -1.0, -1.0, 2.0, -1.0, -1.0, 1.0])nzval guarda los números no nulos columna a columna, rowval su fila y colptr[j] indica dónde empieza la columna \(j\) dentro de los otros dos.
function patron(K)
    P = Matrix(K) .!= 0
    P
end
_, K10 = cadena_masas_muelles(10)
K1d = Matrix(spdiagm(-1 => fill(-1.0, 4), 0 => fill(2.0, 5), 1 => fill(-1.0, 4)))
Kmalla = kron(I(5), K1d) + kron(K1d, I(5))                                  # malla 5×5: 25 grados de libertad
fig = Figure(size=(860, 400))
for (j, (K, titulo)) in enumerate(((Matrix(K10), "cadena (n = 10): tridiagonal"), (Kmalla, "malla 5×5: tridiagonal por bloques")))
    ax = Axis(fig[1, j]; title=titulo, titlealign=:left, titlesize=13, yreversed=true, aspect=DataAspect(), xlabel="columna", ylabel="fila")
    heatmap!(ax, 1:size(K, 2), 1:size(K, 1), Float64.(patron(K))'; colormap=[:white, AZUL], colorrange=(0, 1))
end
fig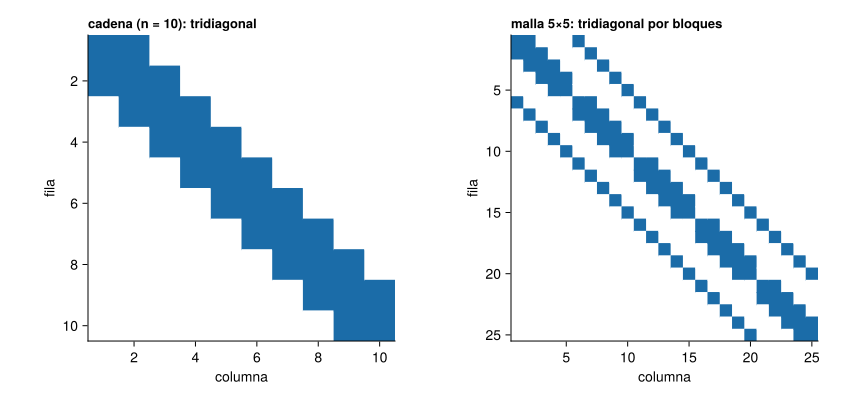
¿Qué se ahorra? Almacenamiento: de \(8n^2\) bytes (densa, Float64) a unos \(16\cdot(3n-2)+8(n+1)\) (CSC). Tiempo: resolver un sistema tridiagonal cuesta \(O(n)\) operaciones; una factorización densa, \(O(n^3)\). La tabla compara memoria y tiempos de resolver \(\mathbf K\mathbf x=\mathbf f\) en un ordenador concreto.
function bench(n)
    _, Ks = cadena_masas_muelles(n)
    Kd = Matrix(Ks); b = ones(n)
    Ks \ b; Kd \ b                                        # calentamiento (compilación)
    ts = minimum(@elapsed(Ks \ b) for _ in 1:7)
    td = minimum(@elapsed(Kd \ b) for _ in 1:7)
    (n=n, nnz=nnz(Ks), mem_d=sizeof(Kd), mem_s=Base.summarysize(Ks), ts=ts, td=td)
end
res = [bench(n) for n in (2, 3, 10, 100, 1000, 2000)]
fmt_b(b) = b < 1e3 ? "$(b) B" : b < 1e6 ? "$(coma(b / 1e3; d=1)) kB" : "$(coma(b / 1e6; d=1)) MB"
fmt_t(t) = t < 1e-3 ? "$(coma(t * 1e6; d=1)) µs" : "$(coma(t * 1e3; d=2)) ms"
println("| n | no nulos | densa | dispersa | resolver (densa) | resolver (dispersa) |\n|---|---|---|---|---|---|\n" *
join(["| $(r.n) | $(r.nnz) | $(fmt_b(r.mem_d)) | $(fmt_b(r.mem_s)) | $(fmt_t(r.td)) | $(fmt_t(r.ts)) |" for r in res], "\n"))| n | no nulos | densa | dispersa | resolver (densa) | resolver (dispersa) |
|---|---|---|---|---|---|
| 2 | 4 | 32 B | 248 B | 0,1 µs | 3,3 µs |
| 3 | 7 | 72 B | 304 B | 0,1 µs | 3,7 µs |
| 10 | 28 | 800 B | 696 B | 0,5 µs | 4,2 µs |
| 100 | 298 | 80,0 kB | 5,7 kB | 34,7 µs | 13,0 µs |
| 1000 | 2998 | 8,0 MB | 56,1 kB | 14,12 ms | 88,6 µs |
| 2000 | 5998 | 32,0 MB | 112,1 kB | 104,68 ms | 202,4 µs |
Los tiempos de la Tabla 1 dependen del procesador, de la versión de Julia y de las bibliotecas (cada vez que se compila la página pueden cambiar). Para \(n=2\) o \(3\) la forma dispersa no ahorra nada, porque la matriz es minúscula y el coste fijo de la estructura domina. Lo que sí es general es la tendencia: la memoria densa crece como \(n^2\) y la dispersa como \(n\); y el coste de resolver, como \(n^3\) (densa) frente a un coste casi lineal en \(n\) (tridiagonal o de banda). Para otras estructuras (mallas bidimensionales, por ejemplo) el ahorro es menor y depende de cómo se numeren los nodos.
Factorizaciones adecuadas. Para una matriz simétrica definida positiva, como la de rigidez de una estructura anclada, se usa la factorización de Cholesky \(\mathbf K=\mathbf L\mathbf L^{\mathsf T}\), que ocupa la mitad de memoria y no necesita pivotear. Si \(\mathbf K\) es de banda con semiancho \(b\), \(\mathbf L\) también lo es, y el coste baja de \(O(n^3)\) a \(O(nb^2)\). Un orden de numeración de nodos que reduzca la banda es parte del diseño de un modelo de elementos finitos (Golub y Van Loan 2013).
¿Cuántos elementos no nulos tiene la matriz de rigidez de una cadena de \(n=100\) masas (\(\mathbf K\) de la ecuación 1)?
\(3n-2=298\): \(n\) en la diagonal y \(n-1\) en cada una de las dos codiagonales. Se comprueba con nnz(cadena_masas_muelles(100)[2]).
Una matriz de rigidez de una estructura con \(n=50\,000\) grados de libertad, ¿cómo conviene almacenarla?
La c. Una matriz densa de \(50\,000^2\) elementos Float64 ocuparía unos \(20\) GB, mientras que la dispersa de una estructura con conectividad local tiene del orden de \(n\) elementos no nulos por fila y cabe en unas decenas de megabytes.
Son las mismas que aparecen en el margen, junto al texto. La lista completa del curso, con el estado de verificación de cada ficha, está en recursos/bibliografia.bib del repositorio.
Golub, Gene H., y Charles F. Van Loan. 2013. Matrix Computations. 4.ª ed. Johns Hopkins University Press.