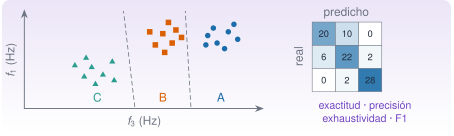
Un sistema de monitorización no se limita a medir: tiene que decidir. ¿Esta ventana de aceleraciones corresponde a la estructura de referencia, a una con variaciones ambientales o a una dañada? ¿Ha ocurrido un evento (un impacto, un paso de vehículo pesado) o solo ruido de fondo? Es un problema de clasificación: aprender, a partir de ejemplos etiquetados, una regla que asigne una etiqueta a un conjunto de características. Plantear la monitorización estructural como reconocimiento estadístico de patrones es el enfoque que desarrollan Farrar y Worden (Farrar y Worden 2012, 2007). Esta unidad construye el flujo completo con el edificio de tres plantas: características espectrales, tres modelos sencillos, validación cruzada para evaluarlos sin engañarse, métricas que cuentan la verdad y la clasificación de eventos, donde la clase que importa es rara.
NotaCómo se lee esta unidad
Tiempo orientativo: 90 minutos. Objetivos (4), teoría en cinco píldoras (18), práctica guiada (40), «Pídeselo a Claude» (12), ejercicios (14) y cierre (2). Los datos son sintéticos: son los registros del edificio de tres plantas de datos/sinteticos/edificio-3-plantas (estados A, B y C de M2) y, para los eventos, impactos añadidos a propósito con una semilla fija; así se conoce la respuesta correcta. No son medidas de ninguna estructura real.
NotaSobre MLJ: por qué esta unidad no lo usa
El temario anuncia esta unidad «con MLJ», el entorno de aprendizaje automático de Julia, que ofrece una interfaz común (machine, fit!, evaluate) a decenas de modelos de otros paquetes. No se usa aquí, por una razón práctica de reproducibilidad: al probar la instalación de MLJ y de los paquetes de modelos que necesitaría (árboles de decisión, regresión regularizada, vecinos próximos), el gestor de paquetes degradaba CSV y Parsers a versiones anteriores, lo que afectaba a las unidades que ya leen datos con ellos. Para no romper el entorno único del curso, los modelos de esta unidad (k vecinos, discriminante lineal y regresión logística), la validación cruzada y las métricas son implementaciones propias, breves y con pruebas, en Resonancia.jl. Tienen una ventaja didáctica: se ve qué hace cada paso.
Qué cambiaría con MLJ. La lógica de la unidad es la misma. Con MLJ se declararía un modelo (KNNClassifier(K=5)), se evaluaría con evaluate(modelo, X, y; resampling=CV(nfolds=5, shuffle=true, rng=1), measure=[accuracy, ...]) y se podrían probar con la misma interfaz árboles, bosques o máquinas de vectores soporte, además de ajustar hiperparámetros y encadenar el escalado con el modelo (pipelines). Una vez entendido lo que sigue, pasar a MLJ es cuestión de aprender su sintaxis y de resolver la compatibilidad del entorno. Documentación: MLJ (consultada el 27-10-2026).
Objetivos y prerrequisitos
Objetivos. Al terminar esta unidad sabrás:
convertir ventanas de señal en una matriz de características y un vector de etiquetas, y explicar por qué hay que estandarizar;
entrenar y aplicar tres clasificadores (k vecinos, análisis discriminante lineal y regresión logística) y describir sus fronteras de decisión;
estimar con validación cruzada (estratificada y repetida) el rendimiento que tendrá un modelo con datos nuevos, y reconocer el sobreajuste y la fuga de información;
leer una matriz de confusión y las métricas de precisión, exhaustividad, F1 y AUC, y elegir un umbral según el coste de una falsa alarma frente a un evento perdido.
Prerrequisitos. El curso no los impone en el temario; conviene J2.4 (frecuencia de los modos por segmentos), J2.5 y J2.6 (azar e inferencia) y J2.7 (regresión, de la que la logística es el equivalente para clases). La teoría del espectro está en M3 y la del edificio de tres plantas, en M2.
Reparto con otras unidades. Aquí se aprende a clasificar y a evaluar. La detección de novedad sin etiquetas de daño (PCA, distancia de Mahalanobis) se trata en M12 y en L7; el análisis de datos reales de una campaña, también en M12.
Teoría breve
NotaUn poco de historia: de las medidas a la clase
Dos de los tres métodos de esta unidad tienen origen en la estadística clásica. En 1936, R. A. Fisher publicó en Annals of Eugenics «The Use of Multiple Measurements in Taxonomic Problems» (volumen 7, número 2, páginas 179–188), el trabajo con el que se asocia el discriminante lineal: combinar varias medidas de un individuo para decidir a qué grupo pertenece. En 1967, T. Cover y P. Hart publicaron en IEEE Transactions on Information Theory «Nearest neighbor pattern classification» (volumen 13, número 1, páginas 21–27), el estudio clásico de la regla de los vecinos más próximos.
Un clasificador no trabaja con señales sino con características (features): números que resumen cada ventana. La matriz de características\(\mathbf X\) tiene una fila por muestra (aquí, una ventana de señal) y una columna por característica; el vector de etiquetas\(\mathbf y\) dice a qué clase pertenece cada fila. Aprender es encontrar una función que, dada una fila nueva, prediga su etiqueta; es aprendizaje supervisado porque las etiquetas de entrenamiento se conocen.
Para distinguir los estados del edificio, la característica natural es la frecuencia de cada modo (J2.4, J2.6): una pérdida de rigidez la baja. Cada registro de 600 s se divide en 30 ventanas de 20 s de la aceleración de la tercera planta; en cada una se estiman las tres frecuencias propias como el pico del espectro de Welch en su banda, refinado con una parábola. Salen 90 muestras con tres características \((f_1,f_2,f_3)\) y tres clases: A (referencia), B (las tres rigideces un 1 % menores, p. ej. por temperatura) y C (el entrepiso 2 pierde un 10 % de su rigidez).
Ver el código
leer(esc) = CSV.read(RAIZ *"datos/sinteticos/edificio-3-plantas/escenario_$esc.csv", DataFrame; delim=';')registros =Dict(esc =>leer(esc).a3_ms2 for esc in ("A", "B", "C"))fs, bandas =100.0, ((0.8, 1.5), (2.5, 3.4), (3.8, 5.0)) # una banda de búsqueda por modocaract(x) =frecuencias_modales(x, fs, bandas; nseg=1024) # f₁, f₂, f₃ de una ventana (Hz)Fe =Dict(e=>caracteristicas_por_ventanas(caract, registros[e], fs, 20) forein ("A", "B", "C"))X =vcat(Fe["A"], Fe["B"], Fe["C"])y =vcat(fill("A", 30), fill("B", 30), fill("C", 30))resumen =DataFrame(estado=["A", "B", "C"], ventanas=[size(Fe[e], 1) for ein ("A", "B", "C")], f1_media=[mean(Fe[e][:, 1]) for ein ("A", "B", "C")], f1_sd=[std(Fe[e][:, 1]) for ein ("A", "B", "C")], f2_media=[mean(Fe[e][:, 2]) for ein ("A", "B", "C")], f2_sd=[std(Fe[e][:, 2]) for ein ("A", "B", "C")], f3_media=[mean(Fe[e][:, 3]) for ein ("A", "B", "C")], f3_sd=[std(Fe[e][:, 3]) for ein ("A", "B", "C")])for c innames(resumen)[3:end] resumen[!, c] =round.(resumen[!, c], digits=3)end(dimensiones_de_X =size(X), resumen = resumen)
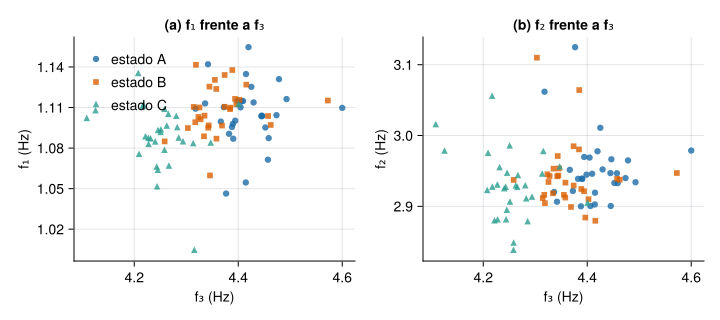
La tercera frecuencia baja de 4,418 Hz (A) a 4,366 Hz (B) y a 4,251 Hz (C); pero cada estimación por ventana tiene una desviación típica de unos 0,055 Hz. La diferencia entre A y C (0,167 Hz) es unas tres veces esa dispersión: se separan bien. La diferencia entre A y B (0,052 Hz) es menor que una desviación típica: las nubes se solapan (Figura 1). No es un fallo del método: el estado B solo tiene un 1 % menos de rigidez, es decir, una frecuencia un 0,5 % menor, y 20 s de señal no bastan para verlo ventana a ventana. En J2.6 se distinguía con un contraste porque comparaba medias de diez estimaciones; clasificar cada ventana es más exigente.
Figura 1: Frecuencias estimadas en las 90 ventanas de 20 s del edificio (sintético). (a) f₁ frente a f₃; (b) f₂ frente a f₃. Los círculos azules son el estado A, los cuadrados naranjas el B y los triángulos verdes el C. C se separa por la izquierda; A y B se solapan.
Hay dos precauciones antes de alimentar un modelo. (1) Las características deben tener escalas comparables: si una se mide en miles y otra en unidades, la distancia euclídea la dominaría la primera. Se estandariza cada columna (restar su media y dividir por su desviación típica), y con los datos de entrenamiento solamente (J2.8.3). (2) La etiqueta no puede colarse en las características. Si el estado se infiriese de algo que solo existe porque se conoce el estado (el nombre del fichero, la hora de la campaña), el modelo parecería perfecto y no serviría en campo.
Si en lugar de ventanas de 20 s se usaran ventanas de 10 s (sin solape) en los tres registros de 600 s, ¿cuántas muestras tendría la matriz \(\mathbf X\)?
60 ventanas por registro y 3 registros: 180 muestras. Ventanas más cortas dan más muestras, pero cada estimación de frecuencia es más ruidosa.
Para que el modelo distinga mejor los estados conviene incluir entre las características el nombre del fichero del que sale cada ventana.
Falso. Es una fuga de información: el nombre contiene la respuesta. El modelo acertaría siempre con los datos que tiene y fallaría con ventanas de campo, que no la traen.
J2.8.2 Tres clasificadores sencillos
k vecinos más próximos (k-NN). No tiene fase de ajuste: guarda los datos de entrenamiento y, para una muestra nueva, busca los \(k\) más cercanos (distancia euclídea sobre las características estandarizadas) y vota. Con \(k=1\) copia la etiqueta del vecino más próximo, y con \(k\) grande promedia sobre muchos vecinos. El valor de \(k\) es un hiperparámetro: no se aprende, se elige.
Análisis discriminante lineal (LDA). Supone que cada clase es una nube gaussiana con su propia media pero la misma covarianza\(\boldsymbol\Sigma\) en todas. Con eso, la probabilidad de cada clase para un punto \(\mathbf x\) sale de unas funciones lineales en \(\mathbf x\), de modo que las fronteras entre clases son rectas (planos en más dimensiones). Se estiman las medias, la covarianza combinada y la frecuencia de cada clase: no hay iteraciones.
Regresión logística. Para dos clases, modela la probabilidad de la clase 1 como \[
P(y=1\mid\mathbf x)=\frac{1}{1+e^{-(\beta_0+\boldsymbol\beta^{\mathsf T}\mathbf x)}},
\tag{1}\] una función que pasa de 0 a 1 de forma suave. Es la hermana de la regresión de J2.7 para etiquetas en lugar de valores continuos, y sus coeficientes se obtienen maximizando la verosimilitud por mínimos cuadrados ponderados iterados (el método de Newton). Se usa en J2.8.5.
Los tres se aplican con la misma interfaz: ajustar_… devuelve un modelo y predecir(modelo, X) las etiquetas (y probabilidades, las probabilidades por clase). ajustar_escalado envuelve a cualquiera de ellos para que estandarice con los datos con los que se entrena. Si se entrena y se evalúa con los mismos datos, el resultado es engañoso:
Con \(k=1\) la exactitud es 1,00 por construcción: el vecino más próximo de una muestra de entrenamiento es ella misma. Con \(k=5\) baja a 0,86 y con LDA, a 0,79. Ninguna de estas cifras dice cómo se comportará el modelo con ventanas nuevas.
Ver el código
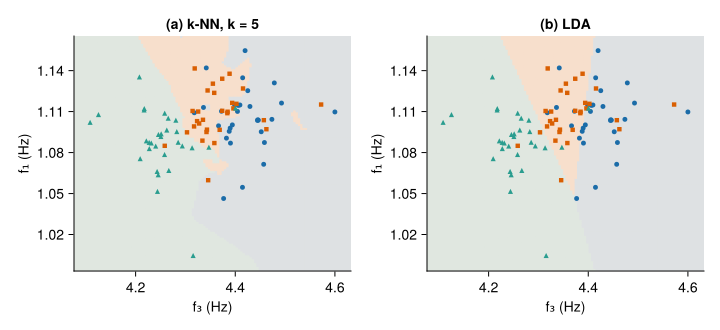
let X2 = X[:, [3, 1]] xs =range(minimum(X2[:, 1]) -0.03, maximum(X2[:, 1]) +0.03, length=120) ys =range(minimum(X2[:, 2]) -0.01, maximum(X2[:, 2]) +0.01, length=120) G =reduce(vcat, [xv yv] for yv in ys for xv in xs) # rejilla de puntos (x más rápido que y) clasesl = ["A", "B", "C"]suave(c) = Makie.Colors.weighted_color_mean(0.2, c, Makie.Colors.RGB(1, 1, 1)) paleta = [suave(AZUL), suave(NARANJA), suave(VERDE)] col =Dict("A"=> AZUL, "B"=> NARANJA, "C"=> VERDE) mk =Dict("A"=>:circle, "B"=>:rect, "C"=>:utriangle) fig =Figure(size=(720, 330))for (j, (aj, titulo)) inenumerate(((aj_knn(5), "(a) k-NN, k = 5"), (aj_lda, "(b) LDA"))) mod =aj(X2, y) pred =predecir(mod, G) Z =reshape([findfirst(==(p), clasesl) for p in pred], length(xs), length(ys)) ax =Axis(fig[1, j], title=titulo, xlabel="f₃ (Hz)", ylabel="f₁ (Hz)")heatmap!(ax, collect(xs), collect(ys), Float64.(Z), colormap=paleta, colorrange=(0.5, 3.5))forein clasesl idx = y .==escatter!(ax, X2[idx, 1], X2[idx, 2], color=col[e], marker=mk[e], markersize=7)endend figend
Figura 2: Regiones de decisión con solo dos características (f₃ y f₁, estandarizadas) y las 90 ventanas. (a) k-NN con k = 5: la frontera es irregular y sigue a los puntos. (b) LDA: las fronteras son rectas. Los símbolos son los de la figura anterior.
AdvertenciaErrores frecuentes
Evaluar con los datos de entrenamiento: un modelo flexible (k-NN con \(k=1\)) los memoriza y la exactitud sale perfecta. (2) No estandarizar antes de k-NN. (3) Creer que un modelo más complejo es siempre mejor: LDA, con solo rectas, rinde igual o mejor que k-NN con tan pocos datos (J2.8.3). (4) Olvidar que el resultado cambia al barajar: con 90 muestras, la partición en pliegues influye en la exactitud.
Un clasificador k-NN con \(k=1\) tiene exactitud 1,00 sobre sus datos de entrenamiento, así que será el mejor con datos nuevos.
Falso. Acierta en el entrenamiento porque cada muestra es su propio vecino más próximo; con datos nuevos suele rendir peor que un \(k\) mayor (J2.8.3, Figura 4).
¿Por qué se estandarizan las características antes de aplicar k-NN?
Para que las clases queden equilibradas.
Para que ninguna característica domine la distancia solo por tener unidades o magnitudes mayores.
Para que el modelo no tenga hiperparámetros.
Para eliminar los valores atípicos.
La b. k-NN decide por distancias; si una característica varía en miles y otra en décimas, la primera decide sola. La estandarización no equilibra clases, no quita hiperparámetros ni atípicos.
J2.8.3 Evaluar sin engañarse: validación cruzada
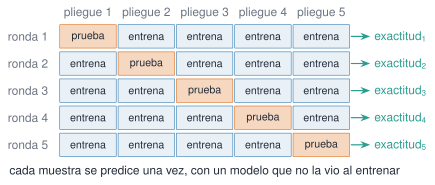
Lo que interesa es el rendimiento con datos que el modelo no ha visto. La forma más directa es reservar una parte (el conjunto de prueba) y no tocarla hasta el final; pero con 90 muestras dejar fuera un tercio desperdicia datos de entrenamiento y la cifra resultante es muy incierta. La validación cruzada de \(k\) pliegues lo aprovecha mejor: se divide el conjunto en \(k\) partes; en cada ronda se entrena con \(k-1\) y se prueba con la restante, de modo que cada muestra se predice una vez con un modelo que no la vio (Figura 3). La exactitud de la validación cruzada es la de esas predicciones.
Figura 3: Validación cruzada de cinco pliegues: en cada ronda, un pliegue se reserva para probar y los otros cuatro entrenan.
Tres detalles técnicos importan. Estratificar: cada pliegue conserva la proporción de clases, imprescindible si una es rara (J2.8.5). Sin fuga de información: la estandarización (y cualquier otra decisión que mire los datos) se calcula dentro de cada pliegue, solo con el entrenamiento; por eso ajustar_escalado forma parte del modelo que se entrena en cada ronda. Repetir: la partición depende de un barajado; con 90 muestras, otro barajado da otra exactitud.
Ver el código
exact_cv(aj, X, y; semilla) =exactitud(matriz_confusion(y, validacion_cruzada(aj, X, y; k=5, perm=randperm(Xoshiro(semilla), length(y))))[1])una_vez = (knn_k5 =exact_cv(aj_knn(5), X, y; semilla=2026), lda =exact_cv(aj_lda, X, y; semilla=2026))rep =Dict(nombre => [exact_cv(aj, X, y; semilla=s) for s in1:20] for (nombre, aj) in ("k-NN (k=5)"=>aj_knn(5), "LDA"=> aj_lda))(una_vez =map(v ->round(v, digits=3), una_vez), repetida_20 =Dict(n => (media =round(mean(v), digits=3), sd =round(std(v), digits=3), min =round(minimum(v), digits=3), max =round(maximum(v), digits=3)) for (n, v) in rep))
(una_vez = (knn_k5 = 0.767, lda = 0.778), repetida_20 = Dict("k-NN (k=5)" => (media = 0.713, sd = 0.02, min = 0.667, max = 0.744), "LDA" => (media = 0.743, sd = 0.025, min = 0.7, max = 0.789)))
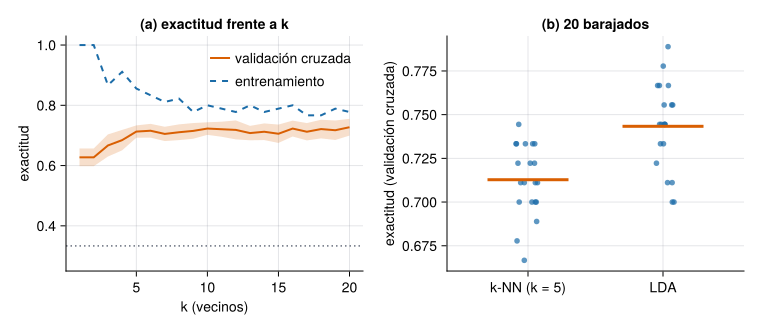
Con una sola partición la exactitud es 0,77 (k-NN) y 0,78 (LDA); repetida con 20 barajados, la media es 0,713 (k-NN, entre 0,667 y 0,744) y 0,743 (LDA, entre 0,700 y 0,789). Dos lecciones. Primera: la exactitud honesta (0,71–0,74) está muy por debajo de la del entrenamiento (0,86 y 0,79) y apenas por encima del 0,33 del azar para tres clases. Segunda: una cifra aislada tiene una incertidumbre de unos 0,02–0,03 solo por el barajado; diferencias menores no permiten declarar un ganador.
Para elegir el hiperparámetro \(k\) se compara la exactitud de la validación cruzada con la del entrenamiento a medida que crece \(k\) (Figura 4):
Ver el código
ks =1:20cv_k = [[exact_cv(aj_knn(k), X, y; semilla=s) for s in1:20] for k in ks]ent_k = [exact_ent(aj_knn(k)(X, y)) for k in ks](k1 = (entrenamiento = ent_k[1], cv =round(mean(cv_k[1]), digits=3)), k5 = (entrenamiento =round(ent_k[5], digits=3), cv =round(mean(cv_k[5]), digits=3)), k20 = (entrenamiento =round(ent_k[20], digits=3), cv =round(mean(cv_k[20]), digits=3)), maxima_cv =round(maximum(mean.(cv_k)), digits=3), en_k = ks[argmax(mean.(cv_k))], dispersion_tipica_entre_barajados =round(mean(std.(cv_k)), digits=3))
Figura 4: (a) Exactitud de k-NN en función de k: sobre los datos de entrenamiento (azul, discontinua) y en validación cruzada de cinco pliegues (naranja, media de 20 barajados y banda de ±1 desviación típica). La línea punteada es el azar con tres clases. (b) Las 20 exactitudes de la validación cruzada repetida de k-NN (k = 5) y LDA, con su media.
Con \(k=1\) el entrenamiento da 1,00 pero la validación cruzada, 0,63: es sobreajuste (el modelo se pega al ruido de las muestras). A partir de \(k\approx5\) la curva de validación se estabiliza en torno a 0,71–0,73 y sus diferencias son menores que la dispersión entre barajados (≈0,03): declarar «el mejor \(k\)» por el máximo exacto sería ajustar el hiperparámetro al ruido. Como se ha usado la validación cruzada para elegir\(k\), su cifra es algo optimista; para informar del rendimiento final hace falta reservar un conjunto de prueba aparte, que se toca una sola vez (Práctica guiada, paso 1).
Se puede estandarizar todo el conjunto con su media y su desviación típica antes de la validación cruzada: es solo un cambio de unidades y no afecta al resultado.
Falso en rigor. Es una fuga: la media y la desviación del pliegue de prueba entran en el cálculo con el que se transforma el entrenamiento. Aquí el efecto es pequeño, pero con selección de características o con pocos datos puede ser grande; por eso se estandariza dentro de cada pliegue.
¿Cuál es la exactitud media de LDA en validación cruzada de cinco pliegues, con los 20 barajados (semillas 1 a 20) de esta página?
0,743, con una desviación típica de 0,025 entre barajados.
J2.8.4 Métricas: qué dice una matriz de confusión
La exactitud (fracción de aciertos) es un resumen demasiado grueso. La matriz de confusión\(C\) cuenta, en la fila \(i\) y la columna \(j\), las muestras de clase real \(i\) que el modelo predijo como \(j\): la diagonal son los aciertos y lo demás, los errores con su «dirección». De ella salen, para cada clase:
precisión (precision): de lo que el modelo dice que es de esa clase, qué fracción lo es, \(C_{jj}/\sum_i C_{ij}\) (suma de la columna);
exhaustividad (recall, sensibilidad): de lo que es de esa clase, qué fracción encuentra, \(C_{ii}/\sum_j C_{ij}\) (suma de la fila);
F1: media armónica de las dos, \(2PR/(P+R)\).
El F1 macro es la media de los F1 de las clases y trata a todas por igual.
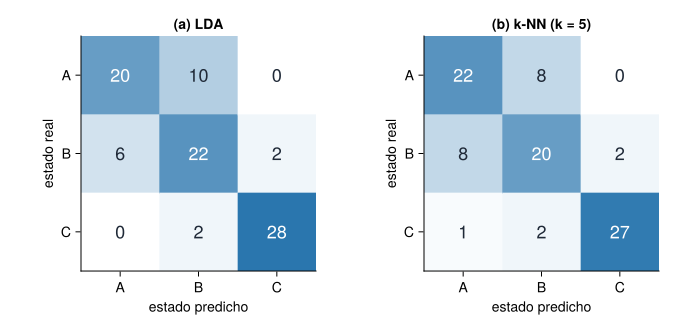
Figura 5: Matrices de confusión en validación cruzada (filas: estado real; columnas: estado predicho). (a) LDA; (b) k-NN con k = 5. El color es más intenso cuanto mayor es el recuento, que también se escribe en cada casilla.
La lectura es la de un ingeniero, no la de un contable. El estado C (daño) se reconoce bien: precisión y exhaustividad de 0,93; solo 2 de 30 ventanas dañadas se toman por B y 2 de B se toman por C. A y B se confunden entre sí: 10 de las 30 ventanas A se clasifican como B (exhaustividad 0,67) y 6 de B como A. Es físicamente razonable: B es la estructura de A con un 1 % menos de rigidez, algo que está dentro del ruido de una ventana de 20 s. La exactitud global de 0,78 oculta esta diferencia: lo que importa en monitorización (detectar el daño sin confundirlo con la variabilidad) funciona mejor que la cifra media sugiere, y lo que no funciona (separar A de B) es un límite de los datos, no del algoritmo. k-NN confunde A con B en 8 y 8 ventanas, con una exactitud similar (0,77).
En la matriz de confusión de LDA, ¿cuál es la exhaustividad (recall) del estado A?
Fila A: 20 aciertos, 10 enviadas a B y 0 a C.
\(20/(20+10+0)=0{,}667\): se encuentran dos de cada tres ventanas A; el resto se toma por B.
Un sistema de alarma de daño debe encontrar casi todos los daños reales, aunque dé alguna falsa alarma. ¿Qué métrica priorizarías para la clase «daño»?
La exactitud global.
La precisión.
La exhaustividad.
Ninguna: basta con el AUC.
La c. La exhaustividad mide qué fracción de los daños reales se detecta. La precisión mide las falsas alarmas, y habrá que vigilarla también, pero el requisito es encontrar los daños.
J2.8.5 Clasificación de eventos: cuando la clase que importa es rara
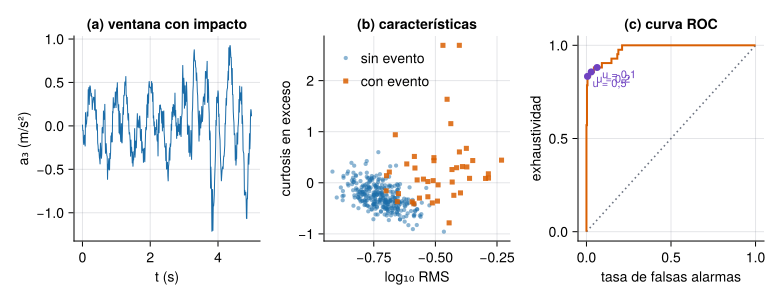
Un evento (un impacto, el paso de un vehículo pesado, una avería del sensor) ocurre en una pequeña fracción del tiempo. Para estudiarlo se parte de ventanas de 5 s de la aceleración de la tercera planta (360 ventanas, las de los tres estados). En el 12 % de ellas, elegidas al azar con una semilla fija, se añade un impacto sintético: la suma de las respuestas libres amortiguadas de los tres modos (\(\zeta=1\,\%\)) a partir de un instante aleatorio, con una amplitud entre 0,2 y 0,8 m/s² en el primer modo. Las características son temporales y no dependen del estado: el logaritmo del valor eficaz (RMS), el factor de cresta (máximo del valor absoluto entre el RMS) y la curtosis en exceso (cuánto pesan las colas respecto de una normal; vale 0 para ruido gaussiano).
Ver el código
functioneventos_sinteticos(registros; seg_s=5, frac=0.12, amp=(0.2, 0.8), semilla=2027) rng =Xoshiro(semilla) m =round(Int, seg_s * fs) ventanas, etiquetas =Vector{Float64}[], Int[]forein ("A", "B", "C"), i in1:length(registros[e]) ÷ m w = registros[e][(i-1)*m+1:i*m] hay =rand(rng) < frac t0 =0.5+ (seg_s -2.0) *rand(rng) # instante del impacto (s) A = amp[1] + (amp[2] - amp[1]) *rand(rng) # amplitud del modo 1 (m/s²) hay && (w = w .+respuesta_libre(m, fs, t0, [1.105, 2.939, 4.390], A .* [1.0, 0.6, 0.4], 0.01))push!(ventanas, w); push!(etiquetas, hay ? 1:0)endreturn ventanas, etiquetasendvent_ev, y_ev =eventos_sinteticos(registros)X_ev =Matrix(reduce(hcat, caracteristicas_evento.(vent_ev))')(ventanas =length(y_ev), con_evento =sum(y_ev), fraccion =round(mean(y_ev), digits=3), exactitud_de_no_detectar_nunca =round(1-mean(y_ev), digits=3))
Hay 42 ventanas con evento de 360 (11,7 %). Un «detector» que nunca avisa acierta el 88,3 % de las veces: con clases tan desequilibradas la exactitud no sirve. Se entrena una regresión logística (ecuación 1) con validación cruzada estratificada (así cada pliegue tiene eventos) y se miran la matriz de confusión, las métricas de la clase «evento» y el AUC: el área bajo la curva ROC, que representa la tasa de eventos detectados (exhaustividad) frente a la tasa de falsas alarmas al recorrer todos los umbrales posibles; vale 0,5 si el modelo no distingue nada y 1 si separa perfectamente. Equivale a la probabilidad de que una ventana con evento reciba una puntuación mayor que una sin él.
Con el umbral habitual de 0,5, el modelo comete 2 falsas alarmas y pierde 7 eventos: la exactitud es 0,975, pero la que importa es la exhaustividad del evento, 0,83 (35 de 42), con una precisión de 0,95. El AUC es 0,978. De las tres características, el RMS por sí solo ya separa bien (AUC 0,952, porque el impacto añade energía), la curtosis aporta algo (0,813) y el factor de cresta casi nada (0,625): como el impacto dura varios segundos de decaimiento y no es un pico aislado, el factor de cresta no lo distingue. El umbral es una decisión de ingeniería, no del modelo: bajarlo detecta más eventos a costa de más falsas alarmas.
Ver el código
filas =map([0.5, 0.3, 0.2, 0.1]) do u C, _ =matriz_confusion(y_ev, Int.(P_ev[:, 2] .>= u); clases=[0, 1]) mm =metricas_por_clase(C) (umbral = u, falsas_alarmas = C[1, 2], eventos_perdidos = C[2, 1], precision =round(mm.precision[2], digits=3), exhaustividad =round(mm.exhaustividad[2], digits=3))endDataFrame(filas)
4×5 DataFrame
Row
umbral
falsas_alarmas
eventos_perdidos
precision
exhaustividad
Float64
Int64
Int64
Float64
Float64
1
0.5
2
7
0.946
0.833
2
0.3
5
7
0.875
0.833
3
0.2
9
6
0.8
0.857
4
0.1
20
5
0.649
0.881
Rebajar el umbral de 0,5 a 0,1 recupera solo dos eventos más (de 7 perdidos a 5) a cambio de pasar de 2 a 20 falsas alarmas y de bajar la precisión a 0,65 (Figura 6). Qué compensa depende del coste: si cada alarma obliga a una inspección costosa, conviene un umbral alto; si perder un evento es peligroso, uno bajo. Los eventos por encima de lo que el modelo puede oír no se arreglan con el umbral: se ve en la práctica.
Figura 6: Clasificación de eventos. (a) Una ventana de 5 s con un impacto sintético sobre el ruido ambiental. (b) Las 360 ventanas en el plano del RMS y la curtosis (cuadrados naranjas: con evento; círculos azules: sin evento). (c) Curva ROC de la regresión logística en validación cruzada, con los puntos de operación de los umbrales 0,5, 0,2 y 0,1.
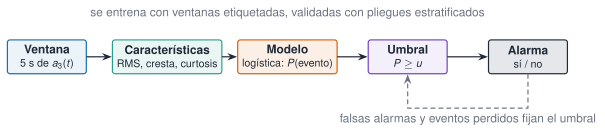
Figura 7: De la señal a la alarma: el modelo da una probabilidad y el umbral, fijado según el coste de cada tipo de error, la convierte en decisión.
NotaIdea clave
Un clasificador solo vale lo que valga su evaluación. Con datos que no ha visto (validación cruzada estratificada y sin fuga), con la métrica que corresponde al problema (exhaustividad y precisión cuando la clase importante es rara, no la exactitud) y con un umbral que refleje el coste real de cada error. Y un resultado débil puede ser una limitación de los datos (A frente a B), no del algoritmo.
¿Cuánto vale el AUC de la regresión logística en la validación cruzada de eventos (semilla 1 del barajado)?
0,978. Un modelo sin capacidad de discriminar daría 0,5.
Un detector de eventos con exactitud del 88 % sobre un conjunto en el que el 12 % de las ventanas tiene evento es un buen detector.
Falso: «no avisar nunca» da exactamente ese 88 %. Hay que mirar la exhaustividad y la precisión de la clase evento.
Para saber más
Farrar y Worden, el planteamiento de la monitorización estructural como aprendizaje automático (Farrar y Worden 2012), y su introducción más breve (Farrar y Worden 2007).
La documentación de MLJ muestra la interfaz común a decenas de modelos, y la de GLM.jl incluye la regresión logística (Binomial() con enlace logit).
La detección de novedad sin ejemplos de daño (PCA, Mahalanobis) se ve en M12 y L7.
Farrar, Charles R., y Keith Worden. 2012. Structural Health Monitoring: A Machine Learning Perspective. Wiley.
Farrar, Charles R., y Keith Worden. 2007. «An introduction to structural health monitoring». Philosophical Transactions of the Royal Society A 365: 303-15. https://doi.org/10.1098/rsta.2006.1928.
Práctica guiada
Vamos a informar del rendimiento con un conjunto de prueba reservado, a reformular el problema como «¿daño sí o no?» y a ver hasta dónde llega el detector de eventos.
Paso 1. Conjunto de prueba reservado. Se separa, con estratificación, un tercio de las ventanas (30) que no se usará hasta el final. Con las 60 restantes se elige \(k\) con validación cruzada repetida (10 barajados) y se mide una sola vez en el conjunto de prueba:
La validación cruzada elige \(k=9\) (0,708; con \(k=1\) solo 0,547). En el conjunto de prueba, k-NN acierta 0,80 y LDA 0,73, pero con solo 30 muestras una exactitud tiene una incertidumbre típica de \(\sqrt{0{,}75\cdot0{,}25/30}\approx0{,}08\): la diferencia entre ambos (0,07) no permite preferir uno. El conjunto de prueba sirve para dar una cifra honesta, no para volver a elegir.
Paso 2. «¿Daño sí o no?». Para vigilar un edificio importa menos distinguir A de B que detectar C. Se agrupan A y B como «sin daño» (0) y C como «daño» (1) y se ajusta una regresión logística con las tres frecuencias, y otra solo con \(f_3\):
El AUC es 0,962 con las tres frecuencias y 0,958 solo con \(f_3\): la tercera frecuencia lleva casi toda la información (el daño del entrepiso 2 es el que más baja el tercer modo). El detector comete 2 falsas alarmas y 2 pérdidas en 90 ventanas (precisión y exhaustividad de 0,93). Los coeficientes están en unidades de desviación típica (estandarizados): el de \(f_3\) (−4,22) es con mucho el mayor en valor absoluto, y negativo, porque bajar la frecuencia sube la probabilidad de daño.
Paso 3. Coste del umbral. Sobre las probabilidades de eventos de J2.8.5, ¿qué umbral hace falta para detectar al menos el 90 % de los eventos y cuántas falsas alarmas cuesta?
Hace falta bajar el umbral a 0,063 para llegar a una exhaustividad de 0,905, y entonces se dan unas 9 falsas alarmas por cada 100 ventanas sanas. Es el compromiso de la curva ROC.
Paso 4. El límite de lo detectable. Si los impactos son más débiles (amplitud entre 0,08 y 0,3 m/s², comparable al ruido de 0,2 m/s² de RMS de la señal), el modelo ya no los oye:
El AUC cae a 0,719 y la exhaustividad a 0,095 (4 eventos de 42), pero la exactitud sube a 0,892, mejor que el 0,883 de «no avisar nunca». Es la trampa de la exactitud en estado puro: un modelo casi inútil parece mejorar. Para eventos tan débiles hace falta otra característica (por ejemplo, la energía en banda en torno a los modos) o un sensor más sensible.
La versión probada con pytest está en python/clasificacion.py: las mismas funciones (k-NN, LDA, regresión logística por IRLS, pliegues estratificados, matriz de confusión, métricas y ROC) con numpy, y scipy.signal.welch para el espectro. Como el espectro de scipy y el de Resonancia.jl no coinciden en el último decimal, las pruebas comprueban las identidades (el gradiente de la logística se anula, el AUC coincide con el estadístico \(U\) de Mann–Whitney) y la recuperación de los resultados de la página (medias por estado, exactitud de LDA entre 0,65 y 0,85, AUC de eventos por encima de 0,9).
import numpy as np, pandas as pdimport clasificacion as clbandas = ((0.8, 1.5), (2.5, 3.4), (3.8, 5.0))X, y = [], []for e in"ABC": a3 = pd.read_csv(f"datos/sinteticos/edificio-3-plantas/escenario_{e}.csv", sep=";")["a3_ms2"].to_numpy() F = cl.por_ventanas(lambda w: cl.frecuencias_modales(w, 100.0, bandas), a3, 100.0, 20) X.append(F); y += [e] *len(F)X, y = np.vstack(X), np.array(y)def lda_escalado(Xe, ye, Xp): mu, sg = cl.ajustar_escala(Xe)return cl.lda_predecir(cl.lda_ajustar((Xe - mu) / sg, ye), (Xp - mu) / sg)pred = cl.validacion_cruzada(lda_escalado, X, y, k=5, perm=np.random.default_rng(2026).permutation(len(y)))C, clases = cl.matriz_confusion(y, pred)print(C, cl.exactitud(C)) # ≈ 0.75, con A y B confundidas
scikit-learn ofrece lo mismo ya hecho (KNeighborsClassifier, LinearDiscriminantAnalysis, LogisticRegression, StratifiedKFold, classification_report, roc_auc_score); aquí se usa solo numpy para ver qué hay debajo.
NotaQué se ha conseguido
Un flujo completo de clasificación: características espectrales de ventanas, tres modelos sencillos, una evaluación honesta (validación cruzada estratificada, repetida y sin fuga, más un conjunto de prueba reservado), métricas que revelan lo que oculta la exactitud (el daño C se reconoce con una exhaustividad de 0,93 mientras A y B se confunden) y un detector de eventos cuyo umbral se elige según el coste de cada error y cuyo límite de sensibilidad se ha localizado.
«Pídeselo a Claude»
TipPrompt
«Con Julia, --project=. y Resonancia.jl (sin instalar paquetes nuevos: MLJ no está en el entorno): lee escenario_A.csv, escenario_B.csv y escenario_C.csv de datos/sinteticos/edificio-3-plantas (separador ;, 100 Hz, columna a3_ms2). Divide cada registro en ventanas de 20 s y calcula con frecuencias_modales (nseg=1024, bandas 0,8–1,5, 2,5–3,4 y 3,8–5,0 Hz) las tres frecuencias de cada una. Clasifica el estado A/B/C con k-NN (k = 5) y con LDA, estandarizando dentro de cada pliegue (ajustar_escalado), con validación cruzada estratificada de 5 pliegues y la permutación randperm(Xoshiro(2026), 90). Dame la matriz de confusión, la exactitud y la precisión, exhaustividad y F1 de cada estado, y repite la validación con 20 barajados (semillas 1 a 20) para darme media y desviación típica. Explica qué estados se confunden y por qué. No inventes cifras: si algo no sale, dilo. Di claramente que los datos son sintéticos.»
Verifica. (a) Que ha estandarizado dentro de cada pliegue y no con todos los datos, y que los pliegues son estratificados. (b) Que la matriz de LDA es [20 10 0; 6 22 2; 0 2 28] (exactitud 0,778) y que la de k-NN es parecida, con A y B confundidos y C bien reconocido (exhaustividad ≈ 0,93). (c) Que la media con 20 barajados es de unos 0,74 (LDA) y 0,71 (k-NN), con desviación de unos 0,02–0,03, y que no declara un ganador con esa diferencia. (d) Que no informa de la exactitud sobre los datos de entrenamiento como si fuera la del modelo. (e) Que presenta los datos como sintéticos y que no ha añadido paquetes.
Ejercicios
En la matriz de confusión de LDA, ¿cuál es la precisión del estado C?
Columna C: 0 de A, 2 de B y 28 de C han sido predichas como C.
\(28/(0+2+28)=0{,}933\).
En el detector de eventos con umbral 0,5, ¿qué exhaustividad tiene la clase «evento»?
35 de los 42 eventos se detectan: \(35/42=0{,}833\).
En la clasificación de eventos conviene estratificar los pliegues para que cada uno contenga ventanas con evento.
Verdadero. Con un 12 % de eventos, un pliegue sin estratificar podría quedarse casi sin ninguno y la métrica de esa ronda carecería de sentido.
Un compañero dice: «Mi clasificador de estados tiene un 100 % de exactitud» y enseña los resultados de k-NN con \(k=1\) sobre sus 90 ventanas. ¿Qué le preguntarías y qué le propondrías antes de fiarte?
Pregunta con qué datos se ha evaluado y si el modelo los había visto al entrenar (con \(k=1\) el 100 % es automático).
Propone validación cruzada estratificada, con la estandarización dentro de cada pliegue, y repetirla con varios barajados.
Pide la matriz de confusión y la métrica adecuada a lo que importa (daño detectado frente a falsas alarmas), no solo la exactitud.
Menciona un conjunto de prueba reservado para la cifra final, y que A y B (1 % de rigidez) probablemente se confunden.
La doy por superada si…
Construyo una matriz de características y un vector de etiquetas a partir de ventanas de señal, y estandarizo con los datos de entrenamiento.
Entreno k-NN, LDA y una regresión logística, y explico qué frontera da cada uno.
Evalúo con validación cruzada estratificada, sin fuga de información, y sé por qué una exactitud sobre el entrenamiento engaña.
Leo una matriz de confusión y calculo precisión, exhaustividad, F1 y AUC.
Elijo el umbral de un detector de eventos según el coste de las falsas alarmas y de los eventos perdidos.
Cierre. Escribe tres líneas: qué he entendido, qué todavía no domino y cuál es mi siguiente paso pequeño. Cuando Claude te dé un clasificador, pídele siempre cómo lo ha evaluado, la matriz de confusión y qué pasa con la clase rara.
Son las mismas que aparecen en el margen, junto al texto. La lista completa del curso, con el estado de verificación de cada ficha, está en recursos/bibliografia.bib del repositorio.
Farrar, Charles R., y Keith Worden. 2007. «An introduction to structural health monitoring». Philosophical Transactions of the Royal Society A 365: 303-15. https://doi.org/10.1098/rsta.2006.1928.
Farrar, Charles R., y Keith Worden. 2012. Structural Health Monitoring: A Machine Learning Perspective. Wiley.